هوش مصنوعی سازمانی (Enterprise AI) یعنی بهکارگیری مدلهای هوش مصنوعی و یادگیری ماشین روی دادهها، فرایندها و دانش داخلی یک سازمان، در بستری که کنترل کامل آن در اختیار خود سازمان است. هدف آن پاسخ دادن به سوالات عمومی نیست؛ هدف، حل مسئلههای واقعی کسبوکار است: از پیشبینی فروش و تشخیص تقلب گرفته تا پاسخگویی به سوالات کارکنان از روی آییننامهها و مستندات داخلی.
وقتی از ChatGPT یا Gemini سوالی میپرسیم، با یک هوش مصنوعی عمومی سروکار داریم. مدلی که روی دادههای عمومی اینترنت آموزش دیده، از قراردادها، جداول ERP، سوابق مشتریان و رویههای داخلی ما خبر ندارد و هر دادهای که به آن میدهیم از مرز سازمان خارج میشود. هوش مصنوعی سازمانی دقیقا برای پوشش همین نقاط ضعف طراحی میشود: دانش اختصاصی، حفظ محرمانگی، اتصال به سامانههای موجود و پاسخگویی قابل ممیزی.
این مقاله یک مرجع پایه برای مدیران فناوری اطلاعات، معماران نرمافزار و تیمهای داده است که میخواهند بدانند برای راهاندازی هوش مصنوعی سازمانی، از مفاهیم اولیه تا ابزارها، سختافزار، امنیت و ایجنتها، با چه موضوعاتی روبهرو هستند.
آنچه در این مقاله میخوانید
- تفاوت هوش مصنوعی سازمانی با هوش مصنوعی عمومی
- چرا ناگزیر به سمت هوش مصنوعی سازمانی میرویم؟
- ۱. مفاهیم اولیه هوش مصنوعی سازمانی
- ۲. ابزارهای هوش مصنوعی سازمانی بدون نیاز به اینترنت
- ۳. روشهای خواندن و درک اطلاعات سازمانی
- ۴. تواناییهای فنی برای پیادهسازی
- ۵. الزامات سختافزاری
- ۶. نکات امنیتی و بهرهبرداری صحیح
- ۷. یادگیری ماشین و نقش آن در هوش مصنوعی سازمانی
- ۸. ایجنت هوش مصنوعی و روشهای ساخت آن
- سوالات متداول
تفاوت هوش مصنوعی سازمانی با هوش مصنوعی عمومی
هر دو از یک خانواده فناوری استفاده میکنند، اما در منبع دانش، محل پردازش و میزان کنترل تفاوت اساسی دارند. جدول زیر مهمترین تفاوتها را نشان میدهد:
| معیار | هوش مصنوعی عمومی | هوش مصنوعی سازمانی |
|---|---|---|
| منبع دانش | دادههای عمومی اینترنت تا تاریخ آموزش مدل | دادههای داخلی سازمان (پایگاهداده، اسناد، ایمیل، تیکتها) در کنار دانش عمومی مدل |
| محل پردازش | سرورهای ارائهدهنده سرویس، معمولا خارج از کشور | دیتاسنتر یا ابر خصوصی سازمان (On-Premise) |
| مالکیت داده | تابع سیاستهای ارائهدهنده سرویس | کاملا در اختیار سازمان |
| کنترل دسترسی | در سطح حساب کاربری | مطابق نقشها و سطوح دسترسی سازمانی (RBAC) |
| یکپارچگی | محدود به رابط چت و API عمومی | متصل به ERP، CRM، BPMS، اتوماسیون اداری و سایر سامانهها |
| ممیزی | محدود و خارج از کنترل سازمان | ثبت کامل پرسشها، پاسخها و اقدامات |
| مدل هزینه | اشتراک ماهانه یا پرداخت به ازای توکن | سرمایهگذاری اولیه روی سختافزار و نیروی متخصص، هزینه نهایی پایین در مقیاس بالا |
به زبان ساده، هوش مصنوعی عمومی از همهچیز کمی میداند، اما هوش مصنوعی سازمانی باید کسبوکار شما را دقیق بشناسد و برای هر پاسخی که میدهد، منبع داشته باشد.
چرا ناگزیر به سمت هوش مصنوعی سازمانی میرویم؟
سالها هوش تجاری (BI) ابزار اصلی تحلیل در سازمانها بود. با انبار داده، مکعبهای OLAP و داشبوردهایی مثل Power BI به سوالاتی مثل «فروش فصل گذشته در هر استان چقدر بود؟» یا «کدام محصول بیشترین مرجوعی را داشت؟» پاسخ میدادیم. BI در پاسخ به «چه اتفاقی افتاد؟» و «چرا افتاد؟» عملکرد خوبی دارد، اما ذاتا گذشتهنگر است.
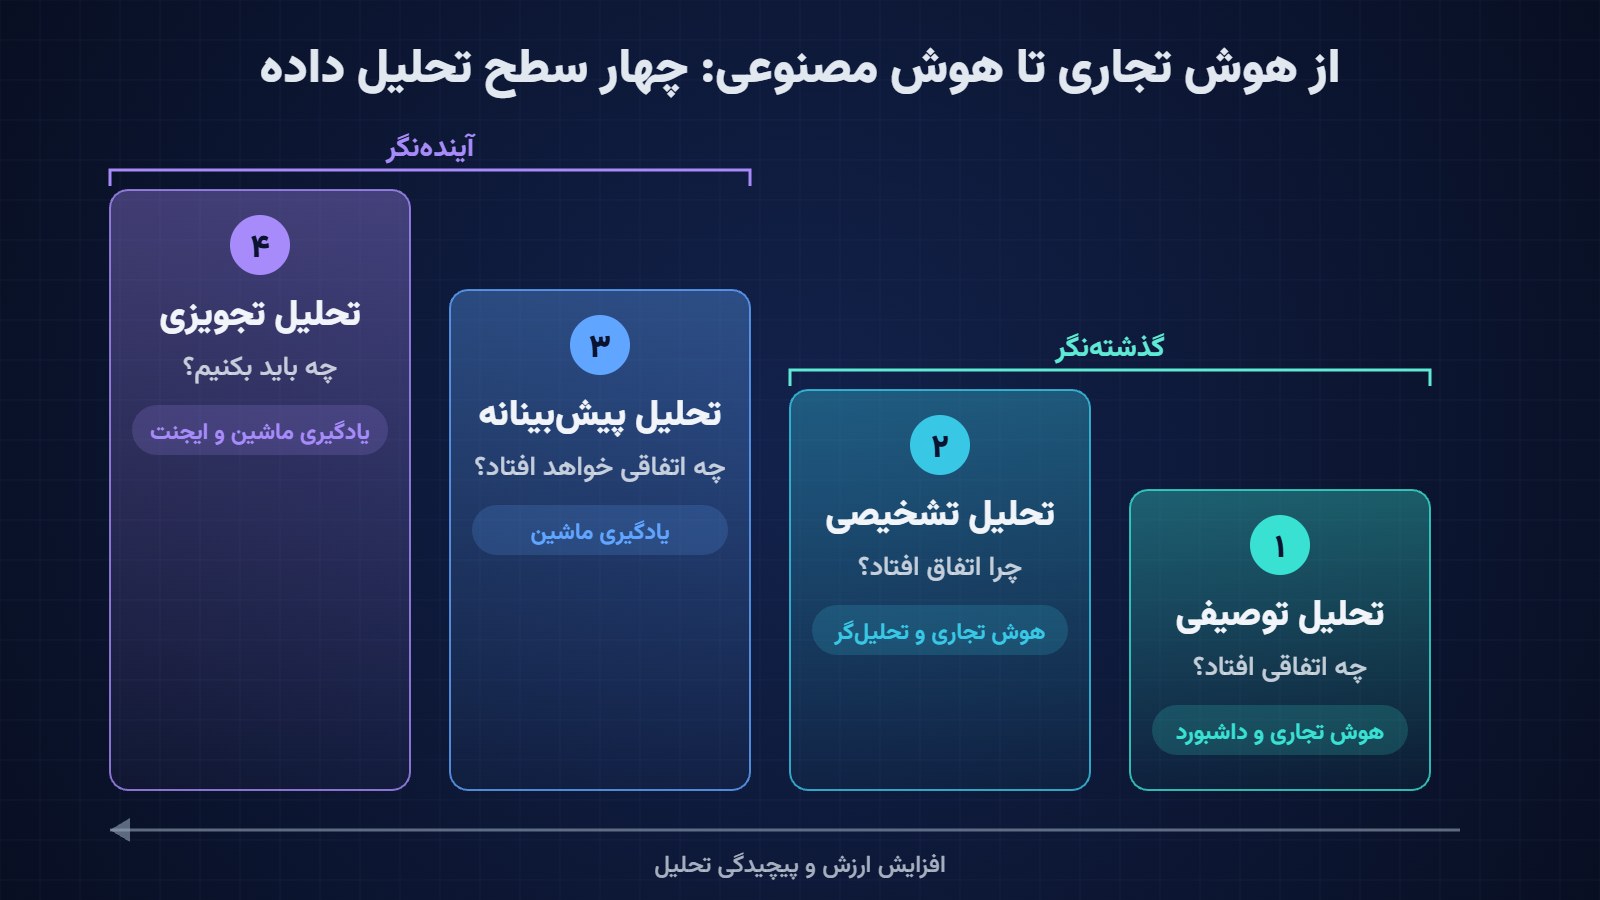
سوال امروز مدیران فرق کرده است. مدیر فروش فقط نمیخواهد بداند ماه قبل چه شد؛ میخواهد بداند ماه بعد چه میشود، کدام مشتری در آستانه ریزش است و موجودی انبار را چطور تنظیم کند که نه کمبود پیش بیاید و نه سرمایه راکد بماند. ربط دادن الگوهای گذشته به پیشبینی آینده با کوئری SQL و نمودار میلهای ممکن نیست. اینجاست که یادگیری ماشین (ML) و هوش مصنوعی وارد میشوند و تحلیل را یک یا دو پله بالاتر میبرند:
- تحلیل توصیفی (Descriptive): چه اتفاقی افتاد؟ قلمرو اصلی BI.
- تحلیل تشخیصی (Diagnostic): چرا اتفاق افتاد؟ ترکیب BI و تحلیلگر انسانی.
- تحلیل پیشبینانه (Predictive): چه اتفاقی خواهد افتاد؟ قلمرو یادگیری ماشین.
- تحلیل تجویزی (Prescriptive): چه کاری باید انجام دهیم؟ ترکیب ML، بهینهسازی و ایجنتهای هوشمند.
جدا از این تحول تحلیلی، چند عامل دیگر هم حرکت به سمت هوش مصنوعی سازمانی را اجتنابناپذیر کردهاند:
- دادههای غیرساختاریافته: بخش بزرگی از دانش سازمان در نامهها، صورتجلسهها، قراردادها و ایمیلها پنهان است و BI اصلا آنها را نمیبیند. مدلهای زبانی میتوانند این دانش را قابل جستوجو و قابل استفاده کنند.
- حاکمیت داده و الزامات قانونی: ارسال اطلاعات مشتریان، اسناد مالی یا دادههای حاکمیتی به سرویسهای خارجی در بسیاری از سازمانها ممنوع یا پرریسک است.
- پایداری سرویس: وابستگی فرایندهای حیاتی به سرویسی که هر لحظه ممکن است به دلیل تحریم، فیلترینگ یا تغییر سیاست ارائهدهنده قطع شود، قابل قبول نیست.
- مزیت رقابتی: سازمانی که زودتر از دادههایش برای تصمیمگیری هوشمند استفاده کند، سرعت تصمیم بالاتر و هزینه عملیاتی کمتری خواهد داشت.
- کمبود نیروی متخصص: بخشی از کارهای تکراری کارشناسی، مثل پاسخ به استعلامها و تهیه پیشنویس گزارش، را میتوان به دستیارهای هوشمند سپرد.
بنابراین هوش مصنوعی سازمانی جایگزین BI نیست. لایهای است که روی همان زیرساخت دادهای که BI ساخته قرار میگیرد و آن را از گزارشگیری به پیشبینی و اقدام میرساند.
۱. مفاهیم اولیه برای هوش مصنوعی سازمانی
پیش از انتخاب ابزار و خرید سختافزار، تیم فنی و مدیران باید زبان مشترکی داشته باشند. مهمترین مفاهیم پایه اینها هستند:
هوش مصنوعی، یادگیری ماشین و یادگیری عمیق
هوش مصنوعی (AI) مفهوم کلی ساخت سیستمهایی است که کارهای نیازمند هوش انسانی را انجام میدهند. یادگیری ماشین (Machine Learning) زیرمجموعهای از آن است که به جای برنامهنویسی صریح قوانین، الگوها را از داده یاد میگیرد. یادگیری عمیق (Deep Learning) هم شاخهای از یادگیری ماشین است که از شبکههای عصبی چندلایه استفاده میکند و پایه مدلهای زبانی امروزی است.
مدل زبانی بزرگ (LLM)
مدل زبانی بزرگ (Large Language Model) مدلی است که روی حجم بسیار زیادی متن آموزش دیده و میتواند متن را درک و تولید کند، خلاصه بنویسد، ترجمه کند، کد بنویسد و به سوالات پاسخ دهد. برای هوش مصنوعی سازمانی معمولا از مدلهای متنباز (Open-Weight) مثل Llama، Qwen، Mistral، Gemma و DeepSeek استفاده میشود که قابل دانلود و اجرا روی سرورهای داخلی هستند. فهرست کامل این مدلها در Hugging Face در دسترس است.
توکن و پنجره متنی (Context Window)
مدلهای زبانی متن را به واحدهای کوچکی به نام توکن تقسیم میکنند. پنجره متنی حداکثر تعداد توکنی است که مدل در یک درخواست میتواند ببیند. این عدد تعیین میکند چه حجمی از اسناد را میتوان همزمان به مدل داد و مستقیما روی مصرف حافظه سختافزار اثر دارد.
امبدینگ (Embedding) و جستوجوی معنایی
امبدینگ تبدیل متن به یک بردار عددی است، طوری که متنهای هممعنا بردارهای نزدیک به هم داشته باشند. به کمک امبدینگ میتوان به جای جستوجوی کلمهبهکلمه، بر اساس معنا جستوجو کرد. مثلا سوال «شرایط مرخصی استعلاجی» به بندی از آییننامه برسد که اصلا کلمه «استعلاجی» در آن نیامده است.
پایگاهداده برداری (Vector Database)
پایگاهدادهای که برای ذخیره و جستوجوی سریع بردارهای امبدینگ بهینه شده است. در معماری هوش مصنوعی سازمانی، این پایگاه نقش «حافظه دانشی» سازمان را دارد.
RAG یا تولید افزوده با بازیابی
RAG (Retrieval-Augmented Generation) مهمترین الگوی معماری هوش مصنوعی سازمانی است. در این روش، پیش از پاسخ دادن، مرتبطترین بخشهای اسناد سازمان بازیابی و همراه سوال به مدل داده میشود. مدل بر اساس همین متنها پاسخ میدهد و میتواند منبع پاسخ را هم ذکر کند. مزیت اصلی RAG این است که بدون آموزش مجدد مدل، دانش آن همیشه بهروز میماند.
فاینتیون (Fine-tuning)
آموزش تکمیلی یک مدل آماده روی دادههای اختصاصی سازمان است. با روشهایی مثل LoRA و QLoRA این کار با سختافزار محدودتر هم ممکن شده است. قاعده سرانگشتی: برای «دانستن» اطلاعات از RAG استفاده کنید و برای «رفتار»، یعنی لحن، قالب خروجی یا اصطلاحات تخصصی یک حوزه، سراغ فاینتیون بروید.
استنتاج (Inference) و کوانتیزهسازی (Quantization)
استنتاج یعنی اجرای مدل آموزشدیده برای تولید پاسخ. کوانتیزهسازی با کاهش دقت عددی وزنهای مدل (مثلا از ۱۶ بیت به ۴ بیت) حجم حافظه مورد نیاز را چند برابر کم میکند و افت کیفیت آن در اغلب کاربردها ناچیز است.
توهم (Hallucination)
تولید پاسخهای نادرست اما با ظاهر قانعکننده. در محیط سازمانی این مهمترین ریسک کیفی است و راهکار اصلی آن، استفاده از RAG، الزام مدل به ارجاع به منبع و ارزیابی مستمر پاسخهاست.
معماری لایهای هوش مصنوعی سازمانی
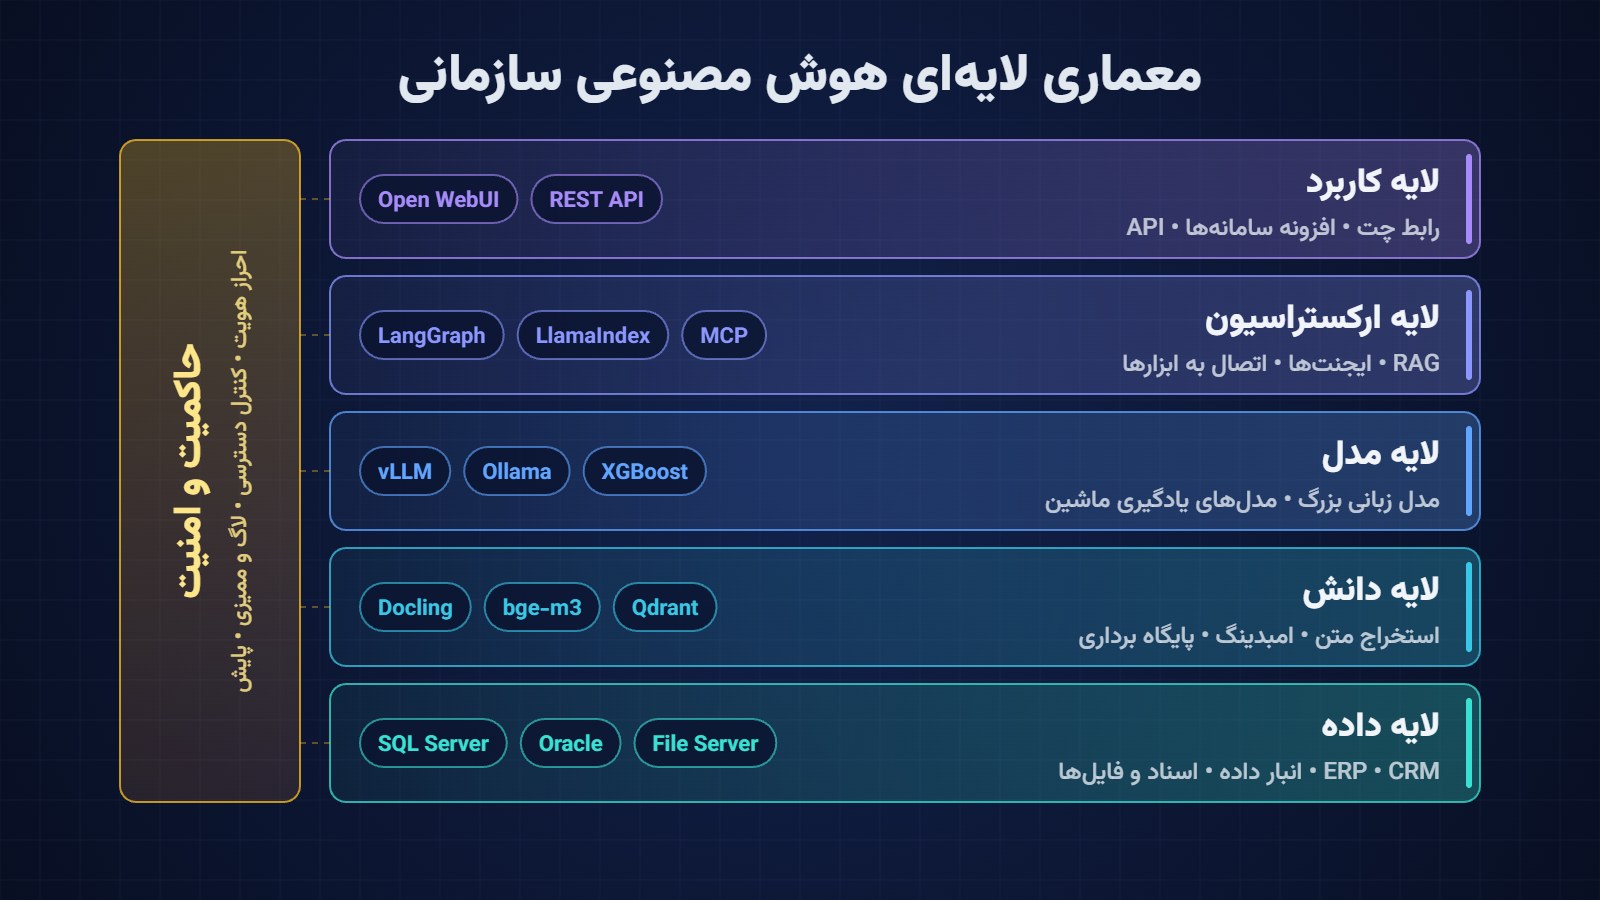
یک معماری مرجع هوش مصنوعی سازمانی معمولا از این لایهها تشکیل میشود:
- لایه داده: پایگاهدادههای عملیاتی، انبار داده، فایلسرورها و سامانههای اسناد.
- لایه دانش: استخراج متن، تکهبندی، امبدینگ و پایگاهداده برداری.
- لایه مدل: مدلهای زبانی و مدلهای یادگیری ماشین روی سرور استنتاج.
- لایه ارکستراسیون: منطق RAG، ایجنتها، اتصال به ابزارها و مدیریت پرامپت.
- لایه کاربرد: رابط چت، افزونه داخل سامانههای موجود و API برای سایر نرمافزارها.
- لایه حاکمیت و امنیت: احراز هویت، کنترل دسترسی، لاگ، پایش و ارزیابی؛ این لایه بهصورت عمودی روی همه لایهها اعمال میشود.
۲. ابزارهای هوش مصنوعی سازمانی بدون نیاز به اینترنت
خبر خوب این است که امروز میتوان یک هوش مصنوعی سازمانی کامل را بهصورت آفلاین و درونسازمانی (On-Premise) راهاندازی کرد. اینترنت فقط برای دانلود اولیه مدلها و بستههای نرمافزاری لازم است و پس از انتقال آنها به شبکه داخلی، حتی در یک شبکه کاملا ایزوله (Air-Gapped)، کل سیستم بدون اینترنت کار میکند.
| لایه | ابزارهای پیشنهادی | کاربرد |
|---|---|---|
| منبع مدل | Hugging Face | دانلود مدلهای متنباز زبانی و امبدینگ |
| اجرای سبک مدل | Ollama، llama.cpp | راهاندازی سریع، اجرا روی CPU یا GPU معمولی، مناسب POC |
| اجرای تولیدی مدل | vLLM، Hugging Face TGI، NVIDIA Triton | سرویسدهی همزمان به تعداد زیاد کاربر با توان عملیاتی بالا |
| رابط کاربری | Open WebUI، AnythingLLM، LibreChat | محیط چت شبیه ChatGPT برای کاربران داخلی |
| پایگاهداده برداری | Qdrant، Milvus، Weaviate، pgvector | ذخیره و جستوجوی معنایی اسناد |
| چارچوب توسعه | LlamaIndex، LangChain، Haystack | ساخت خط لوله RAG و اتصال به منابع داده |
| یادگیری ماشین کلاسیک | scikit-learn، XGBoost، PyTorch | مدلهای پیشبینی روی دادههای جدولی |
| MLOps | MLflow، Kubeflow، Apache Airflow | مدیریت آزمایشها، نسخهبندی مدل و زمانبندی خط لولهها |
| پایش و ارزیابی | Prometheus و Grafana، Langfuse | پایش منابع، ردیابی درخواستها و کیفیت پاسخها |
یک توصیه عملی برای محیطهای ایزوله: از ابتدا یک «مخزن داخلی» راه بیندازید. رجیستری داخلی Docker (مثل Harbor)، آینه داخلی بستههای پایتون (مثل Nexus یا devpi) و یک انبار مدل روی ذخیرهساز داخلی. با این کار نصب، بهروزرسانی و توسعه بدون دسترسی به اینترنت ممکن میشود.
سبد ابزار پیشنهادی برای شروع
- سرور مدل: Ollama برای شروع و vLLM برای محیط تولیدی
- مدل زبانی: یکی از نسخههای Qwen یا Llama با پشتیبانی مناسب از زبان فارسی
- مدل امبدینگ چندزبانه: مثل bge-m3 که عملکرد قابل قبولی روی متون فارسی دارد
- پایگاه برداری: Qdrant
- رابط کاربری: Open WebUI
- چارچوب RAG: LlamaIndex
۳. روشهای خواندن و درک اطلاعات سازمانی و ابزارهای مرتبط
کیفیت خروجی هوش مصنوعی سازمانی مستقیما به کیفیت داده ورودی آن بستگی دارد. قانون قدیمی «ورودی بیکیفیت، خروجی بیکیفیت» اینجا بیش از هر جای دیگری صدق میکند. دادههای سازمان را میتوان در سه دسته بررسی کرد:
دادههای ساختاریافته (پایگاهدادهها)
جداول SQL Server، Oracle یا PostgreSQL در سامانههای ERP، CRM و مالی. دو رویکرد اصلی برای استفاده از آنها وجود دارد:
- Text-to-SQL: مدل زبانی سوال کاربر را به کوئری SQL تبدیل میکند، کوئری اجرا میشود و نتیجه به زبان ساده توضیح داده میشود. موفقیت این روش به کیفیت فرهنگ داده (Data Dictionary) و توضیح جداول و ستونها وابسته است. ابزارهایی مثل Vanna و ماژول SQL در LlamaIndex برای این کار ساخته شدهاند.
- لایه معنایی (Semantic Layer): تعریف شاخصها و مفاهیم کسبوکار (مثل «فروش خالص» یا «مشتری فعال») در یک لایه واحد، تا مدل به جای حدس زدن فرمول، از تعریف رسمی سازمان استفاده کند.
یک قانون مهم: هرگز مدل زبانی را با دسترسی نوشتن به پایگاهداده عملیاتی وصل نکنید. از کاربر فقطخواندنی، Viewهای محدود و ترجیحا نسخه تکثیرشده (Replica) یا انبار داده استفاده کنید.
دادههای نیمهساختاریافته
فایلهای JSON و XML، لاگ سامانهها، ایمیلها و خروجی وبسرویسها. این دادهها معمولا با ابزارهای ETL مثل Apache NiFi یا Airbyte جمعآوری و به قالب یکنواخت تبدیل میشوند.
اسناد غیرساختاریافته
PDF، فایلهای Word و Excel، نامههای اسکنشده و تصاویر. ابزارهای اصلی برای استخراج محتوا:
- Docling و Unstructured: تبدیل اسناد پیچیده به متن ساختارمند با حفظ جدولها و عنوانها
- Apache Tika: استخراج متن و متادیتا از صدها قالب فایل
- Tesseract OCR و PaddleOCR: تبدیل اسناد اسکنشده به متن (Tesseract از زبان فارسی پشتیبانی میکند)
- Hazm: نرمالسازی متن فارسی، مثل یکسانسازی «ی» و «ک» عربی و فارسی و اصلاح نیمفاصلهها
نرمالسازی متن فارسی را دستکم نگیرید. تفاوت «ي» و «ی» یا نبود نیمفاصله میتواند دقت جستوجو را بهطور محسوسی پایین بیاورد.
خط لوله آمادهسازی دانش
مسیر استاندارد تبدیل اسناد خام به دانش قابل جستوجو به این شکل است:
- جمعآوری از منابع (فایلسرور، اتوماسیون اداری، پایگاهداده، ایمیل)
- استخراج متن و OCR
- پاکسازی و نرمالسازی
- تکهبندی (Chunking) با رعایت ساختار سند
- افزودن متادیتا: منبع، تاریخ، واحد سازمانی و مهمتر از همه سطح دسترسی
- تولید امبدینگ و ذخیره در پایگاهداده برداری
- بهروزرسانی افزایشی هنگام تغییر یا حذف اسناد
برای تکهبندی، اندازه ۵۰۰ تا ۱۰۰۰ توکن با همپوشانی ۱۰ تا ۲۰ درصد نقطه شروع مناسبی است. بهتر است تکهها بر اساس عنوانها و بندهای سند جدا شوند و جدولها شکسته نشوند.
جستوجوی ترکیبی و رتبهبندی مجدد
جستوجوی برداری در یافتن معنا قوی است اما در کدها، شمارهها و نامهای خاص (مثل شماره قرارداد یا کد کالا) ضعف دارد. به همین دلیل در محیط سازمانی معمولا از جستوجوی ترکیبی (Hybrid Search) استفاده میشود: ترکیب جستوجوی کلیدواژهای مثل BM25 (در Elasticsearch یا OpenSearch) با جستوجوی برداری، و در پایان یک مدل رتبهبندی مجدد (Reranker) که مرتبطترین نتایج را بالا میآورد.
گراف دانش
وقتی روابط بین موجودیتها مهم است، مثلا ارتباط پروژهها، قراردادها، پیمانکاران و افراد، گراف دانش با ابزارهایی مثل Neo4j و رویکردهایی مثل GraphRAG دقت پاسخ به سوالات چندمرحلهای را بالا میبرد.
۴. تواناییهای فنی برای پیادهسازی هوش مصنوعی سازمانی
هوش مصنوعی سازمانی یک پروژه صرفا دادهمحور نیست؛ ترکیبی از مهندسی نرمافزار، مهندسی داده، زیرساخت و شناخت فرایند است. یک تیم حداقلی برای پیادهسازی موفق به این نقشها نیاز دارد:
| نقش | مهارتهای کلیدی |
|---|---|
| معمار راهحل | طراحی لایهها، یکپارچگی با سامانههای موجود، انتخاب الگوی مناسب (RAG، فاینتیون یا ایجنت) |
| مهندس داده | ETL و ELT، کیفیت داده، مدلسازی پایگاهداده، SQL پیشرفته |
| مهندس یادگیری ماشین و LLM | Python، PyTorch، ارزیابی مدل، فاینتیون، مهندسی پرامپت |
| مهندس نرمافزار بکاند | طراحی API، میکروسرویس، صف پیام، احراز هویت و یکپارچگی با SSO |
| مهندس DevOps و MLOps | Docker، Kubernetes، CI/CD، مدیریت GPU و پایش |
| کارشناس امنیت | مدیریت دسترسی، تست نفوذ روی مدلها، ممیزی و انطباق |
| مالک فرایند کسبوکار | تعریف دقیق مسئله، معیار موفقیت و اعتبارسنجی پاسخها |
مهارتهای فنی پایه
- تسلط بر Python و اکوسیستم داده (Pandas، FastAPI)
- کانتینرسازی با Docker و ارکستراسیون با Kubernetes
- کار با لینوکس، درایورهای NVIDIA و CUDA
- شناخت عمیق پایگاهدادههای سازمان و مدل داده آنها
- طراحی API و یکپارچگی سامانهها (REST، gRPC، صف پیام)
- ارزیابی کیفیت پاسخها با چارچوبهایی مثل RAGAS
مسیر پیشنهادی پیادهسازی
- انتخاب یک مورد کاربرد با ارزش بالا و ریسک پایین، مثل دستیار پاسخگویی به آییننامهها و دستورالعملهای داخلی
- اجرای اثبات مفهوم (POC) در بازه چهار تا هشت هفته
- تعریف معیارهای ارزیابی: دقت پاسخ، زمان پاسخ و رضایت کاربر
- اجرای پایلوت با یک گروه محدود از کاربران واقعی
- ساخت زیرساخت مشترک (سرور مدل، پایگاه برداری، احراز هویت) برای استفاده پروژههای بعدی
- گسترش تدریجی به فرایندهای دیگر
اشتباه رایج، شروع با یک پروژه بزرگ و مبهم مثل «هوشمندسازی کل سازمان» است. پروژههای موفق معمولا کوچک، مشخص و قابل اندازهگیری شروع میشوند.
۵. الزامات سختافزاری هوش مصنوعی سازمانی
در اجرای مدلهای زبانی، گلوگاه اصلی معمولا حافظه کارت گرافیک (VRAM) است، نه قدرت پردازنده. برای برآورد اولیه میتوان از این فرمول ساده استفاده کرد:
حافظه مورد نیاز ≈ تعداد پارامترهای مدل × بایت هر پارامتر؛ در دقت ۱۶ بیتی هر پارامتر حدود ۲ بایت، در ۸ بیتی حدود ۱ بایت و در ۴ بیتی حدود نیم بایت حافظه میگیرد.
| اندازه مدل | حافظه در ۱۶ بیت | حافظه در ۴ بیت | سختافزار پیشنهادی |
|---|---|---|---|
| ۷ تا ۸ میلیارد پارامتر | حدود ۱۶ گیگابایت | حدود ۵ گیگابایت | یک GPU با ۱۶ تا ۲۴ گیگابایت حافظه |
| ۱۳ تا ۱۴ میلیارد پارامتر | حدود ۲۸ گیگابایت | حدود ۹ گیگابایت | یک GPU با ۲۴ تا ۴۸ گیگابایت حافظه |
| ۳۲ میلیارد پارامتر | حدود ۶۴ گیگابایت | حدود ۲۰ گیگابایت | یک GPU با ۴۸ گیگابایت یا دو GPU با ۲۴ گیگابایت |
| ۷۰ میلیارد پارامتر | حدود ۱۴۰ گیگابایت | حدود ۴۰ گیگابایت | دو تا چهار GPU سروری با ۴۸ تا ۸۰ گیگابایت |
این اعداد فقط وزن مدل را نشان میدهند. با افزایش کاربران همزمان و طول متن ورودی، حافظه KV Cache هم اضافه میشود؛ بنابراین حدود ۲۰ تا ۵۰ درصد حاشیه اطمینان در نظر بگیرید.
سایر اجزای زیرساخت
- پردازنده (CPU): سرور با هستههای زیاد برای پیشپردازش اسناد، OCR و مدلهای یادگیری ماشین کلاسیک
- حافظه اصلی (RAM): حداقل دو برابر مجموع VRAM کارتها
- ذخیرهساز: دیسک NVMe برای بارگذاری سریع مدلها و پایگاه برداری؛ هر مدل بزرگ دهها گیگابایت فضا میگیرد
- شبکه: حداقل ۱۰ گیگابیت برای ارتباط سرورها، و در کلاسترهای چندنودی شبکه سریعتر
- برق و خنکسازی: هر GPU سروری بین ۳۰۰ تا ۷۰۰ وات مصرف دارد و طراحی رک و سرمایش باید متناسب با آن باشد
سه سناریوی رایج
- آزمایشگاهی و POC: یک ورکاستیشن با یک GPU ۲۴ گیگابایتی و ۶۴ تا ۱۲۸ گیگابایت RAM. برای مدلهای کوچک، اجرای صرفا روی CPU با llama.cpp هم امکانپذیر است، البته با سرعت پایینتر.
- دپارتمانی (تا حدود ۱۰۰ کاربر): یک سرور با دو GPU سروری ۴۸ گیگابایتی.
- سازمانی: کلاستر چندنودی روی Kubernetes همراه با NVIDIA GPU Operator برای مدیریت و تقسیم منابع GPU.
کارتهای گرافیک خانگی برای POC گزینه اقتصادی خوبی هستند، اما برای سرویسدهی ۲۴ ساعته، کارتهای سروری از نظر پایداری، خنکسازی و پشتیبانی انتخاب مطمئنتریاند.
۶. نکات امنیتی و مهم برای بهرهبرداری صحیح از هوش مصنوعی سازمانی
هوش مصنوعی سازمانی به حساسترین دادههای سازمان دسترسی دارد؛ پس اگر درست طراحی نشود، خودش به یک نقطه نشت اطلاعات تبدیل میشود. منابع مرجع خوبی برای این حوزه وجود دارد، از جمله OWASP Top 10 for LLM Applications، چارچوب مدیریت ریسک هوش مصنوعی NIST و استاندارد ISO/IEC 42001 برای سیستم مدیریت هوش مصنوعی. مهمترین نکات عملی:
کنترل دسترسی در سطح سند
اگر کارمند واحد پشتیبانی اجازه دیدن فیش حقوقی مدیرعامل را ندارد، دستیار هوشمند هم نباید آن را در پاسخ بیاورد. فیلتر دسترسی باید پیش از بازیابی و بر اساس متادیتای هر تکه سند اعمال شود (Permission-Aware Retrieval)، نه اینکه از مدل خواسته شود اطلاعات محرمانه را نگوید.
تزریق پرامپت (Prompt Injection)
مهاجم میتواند با یک دستور پنهان در متن سوال، یا در یک سند، ایمیل یا صفحه وب که مدل آن را میخواند، رفتار مدل را تغییر دهد. محتوای بازیابیشده را همیشه داده در نظر بگیرید، نه دستور؛ ورودیها و خروجیها را فیلتر کنید و اختیارات مدل را محدود نگه دارید.
حفاظت از دادههای حساس
اطلاعات شخصی مثل کد ملی، شماره حساب و شماره تماس را پیش از ورود به خط لوله دانش شناسایی و در صورت نیاز ماسک کنید. لاگها هم نباید به مخزنی از اطلاعات حساس تبدیل شوند.
اصل حداقل دسترسی برای ایجنتها
ایجنتی که میتواند ایمیل بفرستد، سند ثبت کند یا رکوردی را تغییر دهد، باید فقط به ابزارهای لازم دسترسی داشته باشد. اقدامات حساس و غیرقابل بازگشت، مثل ثبت سند مالی یا ارسال نامه رسمی، باید تایید انسانی (Human-in-the-Loop) داشته باشند.
ثبت و ممیزی
همه پرسشها، اسناد بازیابیشده، پاسخها و اقدامات ایجنتها با شناسه کاربر ثبت شوند تا در صورت بروز خطا یا رخداد امنیتی قابل ردیابی باشند.
امنیت زنجیره تامین مدل
مدلها را فقط از منابع معتبر دریافت کنید، هش فایلها را بررسی کنید و قالب safetensors را به قالبهای مبتنی بر pickle ترجیح دهید، چون فایلهای pickle میتوانند کد مخرب اجرا کنند.
ایزولهسازی شبکه
سرورهای مدل در یک ناحیه شبکه جدا قرار بگیرند و دسترسی خروجی آنها به اینترنت بسته باشد. فقط سرویسهای مشخص از طریق API Gateway به آنها دسترسی داشته باشند.
مقابله با توهم و اعتبارسنجی خروجی
مدل را ملزم کنید برای هر پاسخ به منبع ارجاع دهد و در صورت نبود اطلاعات کافی، صریحا بگوید «اطلاعاتی در این مورد پیدا نشد». برای تصمیمهای مهم، خروجی مدل پیشنهاد است، نه حکم نهایی.
حاکمیت و فرهنگ سازمانی
یک سیاست مکتوب استفاده از هوش مصنوعی تدوین کنید، مالک هر سرویس هوشمند را مشخص کنید و کارکنان را آموزش دهید. به پدیده هوش مصنوعی سایه (Shadow AI) هم توجه کنید: وقتی جایگزین داخلی مناسبی وجود نداشته باشد، کارکنان اسناد سازمان را در سرویسهای عمومی کپی میکنند. بهترین کنترل برای این ریسک، ارائه یک ابزار داخلی خوب و در دسترس است.
۷. یادگیری ماشین چیست و چه نقشی در هوش مصنوعی سازمانی دارد؟
یادگیری ماشین (Machine Learning) شاخهای از هوش مصنوعی است که در آن سیستم به جای اجرای قوانین از پیش نوشتهشده، الگوها را از دادههای گذشته یاد میگیرد و از آنها برای پیشبینی یا تصمیمگیری درباره دادههای جدید استفاده میکند. همان پلی که BI نمیتوانست بسازد، یعنی اتصال تحلیل گذشته به پیشبینی آینده، با یادگیری ماشین ساخته میشود.
انواع یادگیری ماشین
- یادگیری نظارتشده (Supervised): مدل با دادههای برچسبدار آموزش میبیند؛ مثلا سوابق مشتریانی که ریزش کردهاند یا نکردهاند.
- یادگیری بدون نظارت (Unsupervised): مدل بدون برچسب، ساختارها و گروههای پنهان داده را پیدا میکند؛ مثل بخشبندی مشتریان.
- یادگیری تقویتی (Reinforcement): مدل با آزمون و خطا و دریافت پاداش، بهترین تصمیم را یاد میگیرد؛ مثل بهینهسازی قیمتگذاری پویا.
کاربردهای یادگیری ماشین در سازمان
| کاربرد | نوع مسئله | نمونه |
|---|---|---|
| پیشبینی فروش و تقاضا | رگرسیون و سری زمانی | برنامهریزی تولید و خرید ماه آینده |
| پیشبینی ریزش مشتری | طبقهبندی | شناسایی مشتریان در معرض ترک و اقدام پیشگیرانه |
| تشخیص تقلب | تشخیص ناهنجاری | شناسایی تراکنشها و اسناد مشکوک |
| بخشبندی مشتریان | خوشهبندی | طراحی کمپینهای هدفمند |
| نگهداری پیشبینانه | سری زمانی و طبقهبندی | پیشبینی خرابی تجهیزات قبل از توقف خط تولید |
| اعتبارسنجی | طبقهبندی | تعیین سقف اعتبار مشتریان و تامینکنندگان |
| بهینهسازی موجودی | پیشبینی همراه با بهینهسازی | تعیین نقطه سفارش و حداقل موجودی انبار |
یادگیری ماشین کلاسیک یا مدل زبانی بزرگ؟
مدلهای زبانی برای کار با زبان، یعنی متن، سند و گفتگو، ساخته شدهاند. برای پیشبینی روی دادههای عددی و جدولی، الگوریتمهایی مثل XGBoost، LightGBM یا جنگل تصادفی هنوز معمولا دقیقتر، سریعتر و بسیار ارزانتر هستند. معماری درست در هوش مصنوعی سازمانی، ترکیب این دو است: مدل یادگیری ماشین پیشبینی میکند و مدل زبانی یا ایجنت، نتیجه را تفسیر میکند، توضیح میدهد و در فرایند به کار میگیرد.
چرخه عمر مدل و MLOps
- تعریف مسئله و معیار موفقیت کسبوکاری
- جمعآوری و آمادهسازی داده، مهندسی ویژگی (Feature Engineering)
- آموزش و ارزیابی مدل روی دادههایی که مدل قبلا ندیده است
- استقرار مدل بهصورت سرویس API یا پردازش دستهای
- پایش عملکرد و تشخیص رانش داده (Data Drift)
- آموزش مجدد دورهای
مدلی که امروز دقیق است، شش ماه بعد با تغییر رفتار بازار ممکن است کاراییاش را از دست بدهد. به همین دلیل MLOps بخش جدانشدنی هر پروژه یادگیری ماشین سازمانی است.
۸. ایجنت هوش مصنوعی چیست و چه روشهایی برای ساخت آن وجود دارد؟
ایجنت هوش مصنوعی (AI Agent) سیستمی است که یک مدل زبانی را بهعنوان «مغز» به کار میگیرد و میتواند برای رسیدن به یک هدف برنامهریزی کند، ابزارها را فراخوانی کند، نتیجه را ببیند و تا رسیدن به هدف ادامه دهد. تفاوت اصلی آن با چتبات این است که چتبات فقط پاسخ میدهد، اما ایجنت اقدام میکند؛ مثلا موجودی انبار را از ERP استعلام میگیرد، پیشنویس درخواست خرید را آماده میکند و آن را برای تایید در سامانه گردش کار ثبت میکند.
اجزای اصلی یک ایجنت
- مدل زبانی: برای درک درخواست، استدلال و تصمیمگیری درباره قدم بعدی
- ابزارها (Tools): APIها، کوئریهای پایگاهداده، جستوجو در اسناد، مدلهای یادگیری ماشین و سایر سامانهها
- حافظه: حافظه کوتاهمدت برای گفتگوی جاری و حافظه بلندمدت برای سوابق و ترجیحات
- برنامهریزی: شکستن یک هدف بزرگ به گامهای کوچکتر
- حفاظها (Guardrails): محدودیتها، قوانین کسبوکار و نقاط تایید انسانی
روشهای ساخت ایجنت
- فراخوانی مستقیم تابع (Function Calling): سادهترین روش؛ ابزارها در کد تعریف میشوند و مدل تصمیم میگیرد کدام را با چه ورودی صدا بزند. برای ایجنتهای کوچک و کنترلشده مناسب است.
- چارچوبهای توسعه ایجنت: LangGraph برای جریانهای کاری حالتدار و قابل کنترل، CrewAI برای ایجنتهای چندنقشی، AutoGen و Semantic Kernel از مایکروسافت، و ماژول ایجنت در LlamaIndex.
- پلتفرمهای کمکد قابل نصب داخلی: ابزارهایی مثل n8n، Dify و Flowise که امکان طراحی بصری جریان ایجنت و اجرای آن روی سرور داخلی را میدهند.
- پروتکل MCP: Model Context Protocol یک استاندارد باز برای اتصال مدلها به ابزارها و منابع داده است. با MCP هر سامانه سازمانی یک بار بهصورت سرور MCP پیادهسازی میشود و همه ایجنتها میتوانند از آن استفاده کنند.
الگوهای معماری ایجنت
- ReAct: چرخه «استدلال، اقدام، مشاهده» که پایه بیشتر ایجنتهای امروزی است.
- برنامهریزی و اجرا (Plan-and-Execute): ابتدا یک برنامه کامل ساخته و سپس گامبهگام اجرا میشود؛ برای کارهای طولانیتر قابل پیشبینیتر است.
- چندایجنتی (Multi-Agent): چند ایجنت تخصصی، مثلا ایجنت مالی، حقوقی و تدارکات، زیر نظر یک ایجنت هماهنگکننده کار میکنند.
- انسان در حلقه (Human-in-the-Loop): ایجنت در نقاط حساس متوقف میشود و منتظر تایید انسان میماند.
یک مثال سازمانی: ایجنت تدارکات
کارمندی درخواست میدهد: «برای پروژه X بیست عدد لپتاپ با مشخصات استاندارد لازم داریم.» ایجنت مشخصات استاندارد را از دستورالعمل داخلی میخواند، موجودی انبار را از ERP استعلام میگیرد، سوابق خرید و قیمت تامینکنندگان قبلی را مقایسه میکند، پیشنویس درخواست خرید را آماده میکند و آن را برای تایید مدیر در سامانه BPMS ثبت میکند. تصمیم نهایی با انسان است، اما چند ساعت کار کارشناسی به چند دقیقه میرسد.
توصیه عملی: هر جا فرایند ثابت و قابل پیشبینی است، یک گردش کار (Workflow) مشخص بهتر از یک ایجنت کاملا خودمختار جواب میدهد. خودمختاری را فقط به اندازهای که مسئله واقعا نیاز دارد به ایجنت بدهید.
سوالات متداول درباره هوش مصنوعی سازمانی
هوش مصنوعی سازمانی دقیقا چیست؟
هوش مصنوعی سازمانی بهکارگیری مدلهای زبانی، یادگیری ماشین و ایجنتهای هوشمند روی دادهها و فرایندهای داخلی سازمان است، در زیرساختی که کنترل، امنیت و مالکیت داده آن در اختیار خود سازمان است.
آیا راهاندازی هوش مصنوعی سازمانی بدون اینترنت ممکن است؟
بله. با مدلهای متنباز و ابزارهایی مثل Ollama، vLLM، Qdrant و Open WebUI میتوان کل سیستم را روی سرورهای داخلی و حتی در شبکه کاملا ایزوله اجرا کرد. اینترنت فقط برای دریافت اولیه مدلها و بستهها لازم است.
برای سازمان RAG بهتر است یا فاینتیون؟
در بیشتر موارد شروع با RAG منطقیتر است، چون ارزانتر است، دانش آن با بهروزرسانی اسناد بهروز میماند و امکان ارجاع به منبع دارد. فاینتیون زمانی کاربرد دارد که بخواهید رفتار، لحن یا قالب خروجی مدل را برای یک حوزه تخصصی تغییر دهید.
آیا هوش مصنوعی سازمانی جایگزین BI میشود؟
نه. BI همچنان برای گزارشگیری و پایش شاخصها ضروری است. هوش مصنوعی سازمانی روی همان زیرساخت داده قرار میگیرد و قابلیت پیشبینی، پرسش به زبان طبیعی و اقدام خودکار را به آن اضافه میکند.
حداقل سختافزار برای شروع چیست؟
برای اثبات مفهوم، یک ورکاستیشن با یک کارت گرافیک ۲۴ گیگابایتی و ۶۴ گیگابایت RAM کافی است و امکان اجرای مدلهای ۷ تا ۳۲ میلیارد پارامتری کوانتیزهشده را فراهم میکند.
بزرگترین ریسک امنیتی هوش مصنوعی سازمانی چیست؟
نشت اطلاعات از طریق پاسخهای مدل به کاربرانی که مجوز دیدن آن اطلاعات را ندارند، و تزریق پرامپت. راهکار اصلی، اعمال کنترل دسترسی پیش از بازیابی اسناد و محدود کردن اختیارات مدل و ایجنتهاست.
جمعبندی
هوش مصنوعی سازمانی ادامه طبیعی مسیری است که سازمانها با انبار داده و BI شروع کردند. BI به ما گفت چه اتفاقی افتاده است؛ یادگیری ماشین میگوید چه اتفاقی خواهد افتاد و ایجنتها کمک میکنند بر اساس آن اقدام کنیم. برای رسیدن به این نقطه، سازمان به چند جزء کلیدی نیاز دارد: داده باکیفیت و قابل دسترس، زیرساخت سختافزاری متناسب، ابزارهای متنباز قابل اجرا در محیط داخلی، تیمی با مهارتهای ترکیبی و مهمتر از همه، چارچوب امنیتی و حاکمیتی روشن.
بهترین نقطه شروع، یک مسئله کوچک، مشخص و ارزشمند است. موفقیت در همان پروژه اول، زیرساخت و اعتماد لازم برای گسترش هوش مصنوعی به سایر فرایندهای سازمان را فراهم میکند. در مقالههای بعدی این مجموعه، هر یک از این محورها را با جزئیات فنی بیشتری بررسی خواهیم کرد.